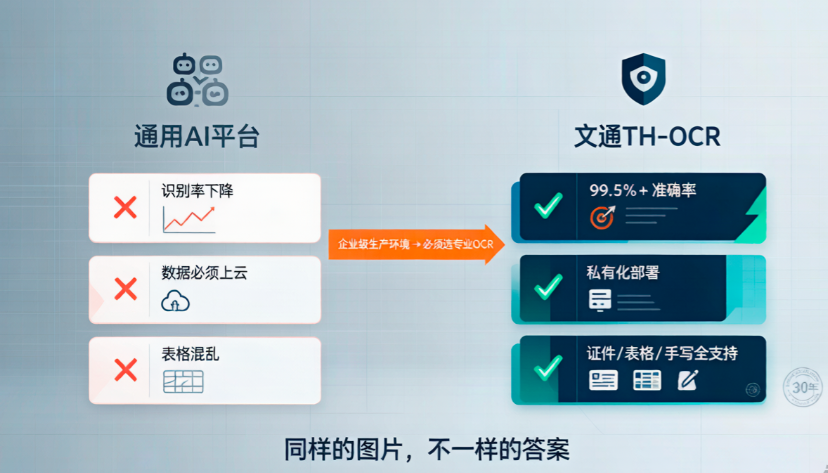
通用AI vs 文通OCR:你看到的只是“识字”,我们做的是“读懂”
2026-05-18DeepSeek、豆包、千问……这些AI平台让OCR变得前所未有的简单。上传一张图,它就能读出上面的文字。不少企业开始好奇:是不是以后所有识别需求,都可以交给通用大模型?
答案是:看场景,更要看代价。
为了搞清楚这个问题,我们用文通科技TH-OCR与上述三个通用AI平台,做了一次跨品类、跨难度的实测对比。测试对象包括:
发票(折角、压线、印章重叠)
证件(身份证、护照、营业执照)
文档(表格、印刷合同、手写快递单)
特殊场景(低照度、倾斜、扭曲、低分辨率)
结果是:通用AI擅长“看得懂”,文通OCR擅长“看得对 + 用得上”。
一、通用AI的优势很明确,但边界也很清晰
DeepSeek、豆包、千问在多模态理解上的确惊艳:
对高清、端正、无干扰的常见文档,识别率可达95%左右
支持自然语言交互,例如“从这张营业执照里提取统一社会信用代码”
无需部署,打开即用
然而,一旦脱离“理想环境”,问题就会暴露
|
对比维度 |
DeepSeek / 豆包 / 千问 |
文通科技 TH-OCR |
|
识别准确率(全品类平均) |
普通文档约94%,复杂场景(脏污/扭曲/低照度)降至85%以下 |
≥99.5%,复杂场景仍保持98%以上 |
|
证件专项优化 |
通用模型,对身份证号码、护照机读区、营业执照二维码识别不稳定 |
✅ 内置公安部、移民局等标准模型,支持人像比对、防伪检测 |
|
手写体识别 |
仅支持工整手写,连笔/潦草识别率极低 |
✅ 专有手写OCR引擎,快递单、审批表、病历都能识别 |
|
表格还原 |
输出混乱,行列关系丢失 |
✅ 完整还原表格结构,支持无框线和复杂合并单元格 |
|
版面分析 |
按阅读顺序输出,无法区分“正文”“标题”“页眉页脚” |
✅ 精细化版面分析,可保留原始阅读顺序和层级 |
|
私有化 & 信创 |
不支持本地部署,数据必须上云 |
✅ 支持纯本地、离线、国产化环境(麒麟/统信/达梦/人大金仓) |
|
单张识别速度 |
2-5秒(含网络延迟) |
≤0.3秒(纯本地引擎) |
|
批量生产能力 |
不保证高并发,容易限流 |
✅ 单机支持每分钟60-200页,可集群线性扩展 |
一个真实的对比案例:
测试一张轻微扭曲的身份证(拍摄于反光台面)。
DeepSeek:名字里的“张”识别成“长”,身份证号码最后一位校验码丢失。
豆包:地址字段被截断,缺少行政区划代码。
千问:把身份证背面“签发机关”与正面信息混在一起。
文通TH-OCR:不仅全部字段正确输出,还自动完成了身份证号码真伪校验和国徽检测。
二、文通科技:不只是OCR,而是“企业级视觉认知”
文通科技做OCR已经超过三十年。从最早的TH-OCR汉字识别,到今天覆盖20多个行业、80余种识别对象、上万家企业客户,它的核心能力不是“读字”,而是在真实生产环境中稳定交付结构化数据。
几个典型场景:
银行 & 保险:批量扫描身份证、银行卡、保单、反洗钱表格,直连核心系统。
政府 & 档案:历史文件数字化,手写繁体、红头文件、盖章遮挡,全部自动处理。
物流 & 电商:手写快递单、电子面单、签收单,识别率行业领先。
医疗:化验单、病历本、诊断证明,支持各种医院自定义格式。
一位头部物流企业的技术负责人曾这样评价:
“通用AI用起来像‘开盲盒’,可能这单识别完美,下一单就崩了。但文通的OCR,我们从测试到上线,误差一直控制在0.3%以内。”
三、什么时候必须用专业OCR?
如果你的使用场景符合以下任意一条,请谨慎选择通用AI:
识别结果进入生产系统(财务、CRM、档案库、执法记录系统)—— 字段错一位,可能带来整条业务链的连锁错误。
数据不能出内网(政府、军工、金融、医疗)—— 通用AI强制上传云端,存在合规风险。
需要处理复杂文档(折叠、水印、印章、模糊、手写、低分辨率)—— 大模型的鲁棒性远未达到工业级要求。
需要高并发、低延迟(窗口柜台、自动化流水线)—— 通用AI的网络请求和排队时间无法接受。
需要长期稳定、可预测的成本 —— 通用AI按token计费,量大了反而贵;文通私有化一次部署,边际成本趋近于零。
一个典型的成本对比:
某政务服务中心每天处理3000张证件(身份证、居住证、营业执照)。使用通用AI API,一年调用费用约6-8万元,且每张需要人工复核错误项,年复核成本约5万元。迁移到文通本地部署后,三年总成本下降70%,错误率下降96%。
四、写在最后
DeepSeek、豆包、千问让AI的能力变得触手可及,这是一件好事。它们适合快速验证、一次性识别、对准确率要求不高的场景。
但在企业级、高可靠、数据敏感、环境复杂的真实业务中,你需要的是文通——一个把OCR当成“脏活累活”做了三十年的专业选手。
我们不追求花哨的对话,只追求一件事:你给一张图,我返回100%可用的结构化数据,从不出错。
现在申请免费试用,我们可以为你提供100张真实业务样本的识别对比报告,直观感受专业OCR与通用AI的差距。
F&Q 常见问题
Q1:文通科技TH-OCR到底支持哪些识别对象?能否列一个比较完整的清单?
A:可以的。文通TH-OCR引擎支持超过80种识别模型,包括但不限于:
证件类:身份证(一代/二代/临时)、护照(多国)、港澳台通行证、居住证、户口本、驾驶证、行驶证、军官证、社保卡、出生医学证明、营业执照(多版本)
票据类:增值税发票(专票/普票/电子/全电)、火车票、飞机行程单、出租车票、过路费票、财政票据、银行支票/进账单
文档类:印刷体文档(中英日韩等多语种)、手写体(中文/英文/数字)、表格(有线/无线/跨页)、试卷、合同、档案
专用类:车牌(蓝/黄/绿/新能源/警用/军车)、集装箱号、钢印号、身份证芯片信息、物流面单、医疗化验单
另外,文通还提供模型定制服务,可针对企业内部特有的单据训练专属识别模型。
Q2:文通OCR支持哪些部署方式?是否支持纯内网环境?
A:全面支持。具体包括:
私有化本地部署:提供SDK、HTTP服务、动态链接库等多种形式,可在Windows/Linux/Arm等环境下运行,完全不依赖互联网。
纯离线嵌入式:适配国产操作系统(麒麟、统信、中科方德)及国产数据库(达梦、人大金仓、神州通用),满足信创合规要求。
公有云API:按调用次数计费,适合中小企业和快速集成场景。
智能硬件一体机:文通高拍仪/扫描仪 + 内置OCR系统,即插即用,无需开发。
Q3:文通OCR的准确率真的有99.5%以上吗?这个数字是什么条件下测出来的?
A:是的。该指标基于文通科技内部及第三方评测机构的大规模测试结果,测试条件如下:
输入质量:分辨率≥150dpi,拍摄/扫描端正,无明显物理遮挡
识别对象:身份证、增值税发票、营业执照、印刷合同等主流文档
评价方式:字段级准确率(字段内容完全正确 ÷ 总字段数),而非字符级
在复杂场景下(如倾斜≤15°、光照不均、印章覆盖、轻微褶皱),文通OCR的准确率仍可维持在98%以上,而通用AI平台通常降至85%-90%。文通对所有识别结果还会输出置信度分值,低置信度字段自动标红提示人工复核,确保不会“暗错”。
作者:文通科技
