GitHub 7万星开源OCR vs 商业SDK,企业该怎么选?
2026-06-09年来,大模型OCR技术蓬勃发展,PaddleOCR、DeepSeek、腾讯Hunyuan、智谱GLM-OCR等开源或免费模型在GitHub上斩获数万星标,吸引了大量开发者和研究人员的关注。然而,当企业真正将OCR技术应用于生产环境时,一个问题浮现出来:GitHub上7万星的开源OCR,为什么很多企业最后还是选择了商业SDK?
什么是文通科技商业OCR SDK?
文通科技商业OCR SDK 是一套面向企业级应用的全功能OCR软件开发工具包。它基于文通自主研发的TH-OCR核心算法与深度学习框架,提供身份证、驾驶证、营业执照、发票、车牌等百余种证照票据的识别能力。与开源模型不同,商业SDK不仅包含高精度的识别引擎,更集成了私有化部署方案、国产化硬件适配、错误样本快速调优工具链、7×24小时企业级技术支持等完整的企业级服务组件。企业可通过API、SDK或一体机形式快速集成,实现OCR能力在生产环境中的稳定、高效、安全运行。
开源OCR的“光环”与“现实”
开源大模型OCR的优势显而易见:免费、前沿、社区活跃。对于学术研究、原型验证、个人项目而言,它们是极佳的选择。但是,当企业将其部署到真实的业务场景中——例如财务报销、身份核验、物流单据处理——一系列现实问题便暴露出来。
问题一:部署稳定性差,环境依赖复杂
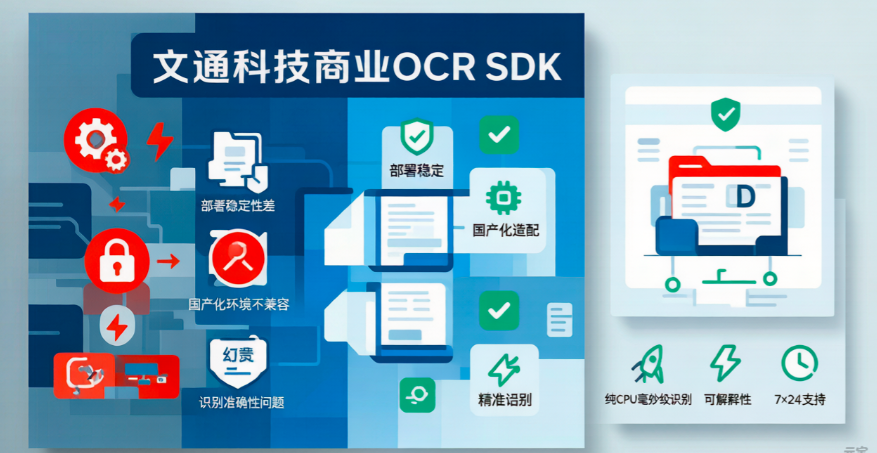
开源模型通常需要配置特定的深度学习框架(如PyTorch、PaddlePaddle)、CUDA版本、Python环境等。企业内部的服务器环境千差万别,稍有不慎便出现依赖冲突、版本不兼容,导致模型无法运行或频繁崩溃。而商业SDK提供一键安装脚本、Docker镜像及Kubernetes部署方案,经过数千家企业生产环境验证,稳定性高达99.99%。
问题二:算力要求高,国产化环境“水土不服”
许多开源大模型OCR为追求SOTA效果,模型体积动辄数百兆甚至数GB,必须依赖高端GPU(如V100、A100)才能达到可用的推理速度。然而,金融、政务等行业的真实环境往往受限于国产化替代要求——服务器采用飞腾、龙芯、鲲鹏等国产CPU,操作系统为麒麟、统信UOS,且无法配备昂贵GPU。开源模型在这些平台上要么无法编译,要么慢到无法使用。文通商业SDK则针对国产芯片和CPU指令集深度优化,纯CPU环境下即可实现毫秒级识别,全面适配信创生态。
问题三:大模型“幻觉”——企业生产环境的大忌
大模型在训练过程中为追求泛化能力,有时会在识别不清时“自作聪明”地补全或修正字符。这种“幻觉”在创意生成场景中或许无伤大雅,但在OCR领域却是致命缺陷。例如,一张模糊的发票上金额为“1000.00”,模型却“猜”成“1000.01”;一份身份证号码末尾“X”被误认为“0”。一个字符的偏差,就可能导致财务对账失败、身份核验不通过、业务流程中断。商业SDK采用确定性算法,严格按图像像素输出识别结果,不猜测、不修正,并提供字符级置信度,企业可根据置信度阈值设置人工复核,确保万无一失。
问题四:错误样本无法快速调优
开源模型遇到识别错误时,企业通常需要自行收集标注数据、重新微调模型,这一过程涉及数据清洗、环境搭建、训练调参,周期长达数周甚至数月,且需要专业的算法工程师。文通商业SDK内置了可视化错误样本标注与增量学习工具,业务人员即可操作:将识别错误的图像拖入工具,框选纠正错误字段,系统自动生成微调数据并更新模型,整个过程不超过1小时。
问题五:技术支持缺位,问题响应慢
开源社区依赖用户自发贡献,提问后可能数天无人回应。而企业生产环境出现故障时,每一分钟停机都意味着业务损失。文通提供7×24小时专属技术支持,紧急问题30分钟内响应,并配备客户成功经理提供定期巡检、性能优化建议。
文通科技商业OCR SDK:专为企业生产环境而生
|
对比维度 |
开源大模型OCR |
文通商业OCR SDK |
|
部署稳定性 |
依赖复杂环境,版本更新易出问题 |
一键部署,Docker/K8s友好,长期稳定运行 |
|
硬件适配 |
主要适配高端GPU,CPU效率极低 |
支持CPU/GPU/国产芯片(飞腾、龙芯、鲲鹏),纯CPU毫秒级识别 |
|
识别准确性 |
存在“幻觉”,可能自行补全错误字符 |
严格按图像输出,可解释、可追溯,不猜不补 |
|
信创国产化 |
几乎没有官方适配 |
全栈适配麒麟/UOS+国产芯片,通过信创测试认证 |
|
错误调优 |
需自行训练模型,门槛高、周期长 |
提供可视化标注工具+增量学习,业务人员可快速调优(小时级) |
|
技术支持 |
社区论坛,响应慢 |
7×24小时企业级支持,专属客户经理,30分钟紧急响应 |
|
长期成本 |
免费但隐性成本高(人力、算力、停机风险) |
明确的一次性授权或年费,总拥有成本可控 |
GitHub 7万星开源OCR,为什么很多企业最后还是选择商业SDK?——因为生产环境不相信“幻觉”,只相信“稳定”。
常见问题(FAQ)
Q1:文通商业OCR SDK是否支持完全离线使用?数据安全如何保障?
A:完全支持离线使用。文通SDK可私有化部署在企业内部服务器,所有图像和识别结果均不离开企业网络。同时,SDK提供数据加密存储、访问日志审计、数字签名防篡改等安全功能,满足金融、政务等行业的等保三级及数据安全法要求。
Q2:如果企业当前已有部分GPU服务器,但还有大量CPU服务器,文通SDK能否混合部署?
A:可以。文通SDK支持异构计算,您可以将高并发或复杂场景识别任务调度至GPU节点,将简单场景或低峰期任务调度至CPU节点。我们提供负载均衡和任务路由配置示例,帮助企业最大化利用现有硬件资源,避免额外采购。
Q3:文通SDK遇到识别错误时,调优的具体流程是怎样的?需要算法工程师吗?
A:不需要算法工程师。调优流程如下:① 登录文通管理后台,进入“错误样本库”;② 系统自动展示最近识别置信度低于阈值的图像;③ 业务人员用鼠标框选错误字段,输入正确文字;④ 点击“提交训练”,系统后台自动进行增量学习(约10-30分钟);⑤ 更新模型后,同类型错误识别准确率显著提升。整个过程无需编写代码,普通财务或IT运维人员即可操作。
立即行动
如果您的企业正在评估OCR技术方案,或者对当前开源模型的稳定性、国产化适配、调优能力感到困扰,欢迎访问文通科技官网申请免费企业版测试包。我们将提供30天全功能试用及一对一部署指导。
文通科技——让OCR在企业生产环境中“跑得稳、识得准、调得快”。
作者:文通科技
